副題:検知をソフトウェアのように開発・テスト・改善する
想定読者:SOC、CSIRT、Detection Engineer、SIEM運用担当
第1回では、従来型SOCがアラート過多から抜け出せない4つの構造を見ました。ルールは足されるだけで削除されず、誤検知は放置され、判断は担当者の経験に頼る。この悪循環を断つ鍵の1つがDetection Engineeringです。本稿では、検知を「作って終わり」にしないためのライフサイクルと、その品質の測り方を扱います。
1. Detection Engineeringとは
Detection Engineeringは、検知ルールを製品の付属機能ではなく開発する成果物として扱い、ソフトウェア開発と同じように設計、テスト、レビュー、リリース、改善を繰り返す考え方です。
ルールをコードとしてバージョン管理し、変更のたびにテストとレビューを通す運用は「Detection as Code」と呼ばれます。誰が、いつ、なぜルールを変えたのかが記録に残り、問題があれば元に戻せます。
観点 | 従来の検知運用 | Detection Engineering |
|---|---|---|
出発点 | 製品の既定ルール、インシデント後の追加 | 脅威の仮説 |
投入前 | 動けばよい | 攻撃の再現と誤検知量をテストする |
記録 | ルール本体だけ | 目的、前提、盲点、対応手順まで文書化 |
投入後 | 放置 | 品質を測り、改善し、不要なら廃止する |
2. 7段階のライフサイクル
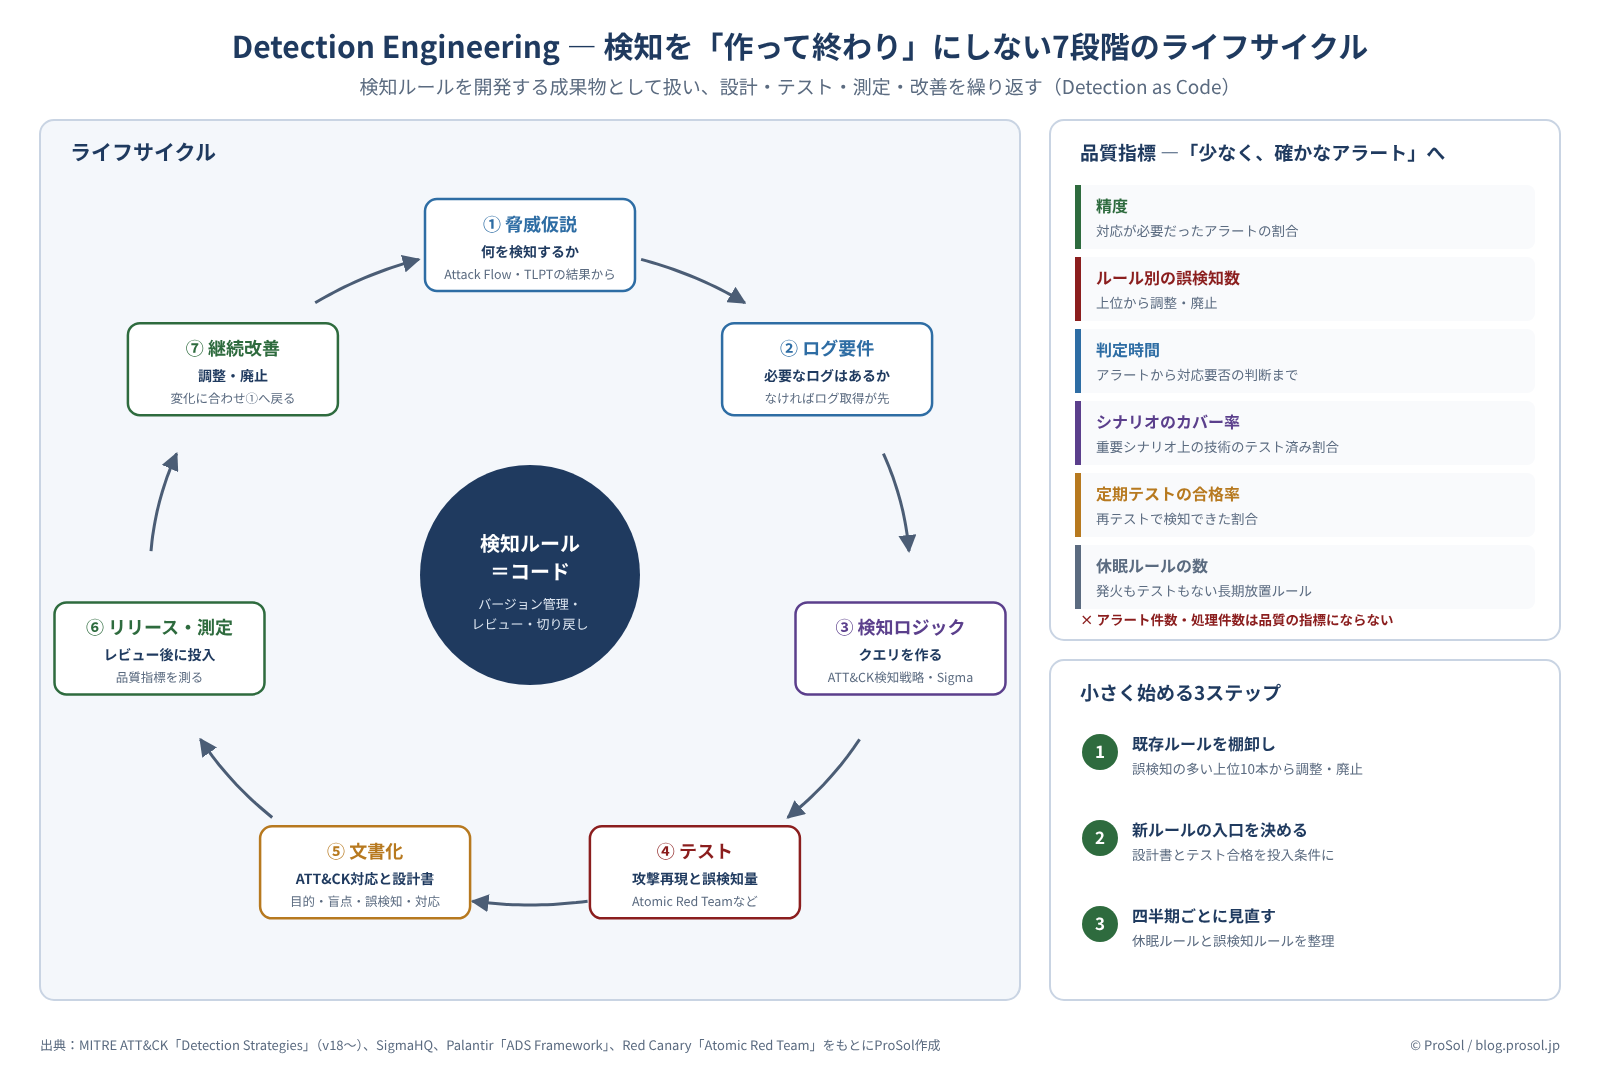
図1 Detection Engineeringのライフサイクルと品質指標(© ProSol)
段階 | やること | 例・ポイント |
|---|---|---|
① 脅威仮説 | 何を検知するかを決める | Series 07で描いたAttack Flowの制御点、TLPTやPurple Teamで見つかった穴から選ぶ |
② ログ要件 | 検知に必要なログが取れているか確認する | 取れていなければ、ルールより先にログ取得を整える |
③ 検知ロジック | 検知のクエリを作る | ATT&CKの検知戦略(Detection Strategies)を参考にする。共通形式Sigmaで書けば、複数のSIEMで使い回せる |
④ テスト | 攻撃を再現して検知できるか、正常な業務で誤検知が出ないかを確かめる | Atomic Red TeamなどATT&CKに対応したテスト集を使う |
⑤ マッピングと文書化 | ATT&CKの技術と対応付け、設計書と対応手順を書く | 次の章の設計書の項目を埋める |
⑥ リリースと測定 | レビューを経て投入し、品質指標を測る | 投入後も「出しっぱなし」にしない |
⑦ 継続改善 | 定期的に見直し、調整または廃止する | 攻撃手口やシステムの変化に合わせて、①に戻る |
MITREはATT&CKの2025年10月のv18で、技術ごとの検知の考え方を「検知戦略」として整理し直しました。検知戦略は、複数のプラットフォーム向けの分析ロジックを1つの検知手法としてまとめるものです。③で何を手がかりに検知するかを考える出発点になります。
3. 検知1本ごとに「設計書」を残す
検知ルールが属人化する最大の原因は、なぜそのルールがあるのかが残っていないことです。Palantirが2017年に公開したAlerting and Detection Strategy(ADS)フレームワークは、検知ごとに次のような項目を文書化するよう提案しています。
項目 | 例:Kerberoastingの検知 |
|---|---|
目的 | 特権IDの奪取につながるサービスアカウントの認証情報窃取を検知する |
分類 | ATT&CK T1558.003(Kerberoasting) |
検知の考え方 | 短時間に多数のサービスチケットを要求する、通常と異なる端末やアカウントを検出する |
盲点と前提 | ドメインコントローラの該当ログが取得されていることが前提 |
想定される誤検知 | 脆弱性スキャナや監視ツールの正規の動作 |
検証方法 | テスト集で攻撃を再現し、アラートが出ることを確認する |
優先度と対応 | 高。アカウントの確認、該当サービスアカウントのパスワード変更 |
「盲点と前提」と「想定される誤検知」を書いておくことで、後任者も同じ判断ができ、ログの変更で検知が止まったときにも気付けます。
4. 検知の品質を測る指標
- 精度:アラートのうち、実際に対応が必要だったものの割合
- ルールごとの誤検知数:上位のルールから調整・廃止の対象にする
- 判定時間:アラートから「対応要否」の判断までの時間
- シナリオのカバー率:重要な攻撃シナリオ上の技術のうち、テスト済みの検知がある割合
- 定期テストの合格率:再テストで、引き続き検知できたルールの割合
- 休眠ルールの数:長期間発火もテストもされていないルールの数
第1回で見たとおり、アラートの件数や処理件数は品質の指標になりません。「少なく、確かなアラート」を目指します。
5. 小さく始める3ステップ
- 既存ルールを棚卸しする:目的、作成者、直近の発火件数、誤検知件数を一覧にし、誤検知の多い上位10本から調整または廃止する
- 新しいルールの「入口」を決める:設計書の記入とテストの合格を、投入の条件にする
- 四半期ごとに見直す:品質指標を確認し、休眠ルールと誤検知の多いルールを整理する
監視を外部に委託している場合は、どのルールを誰が所有し、誰が変更を承認するかを明確にしておきます。委託先に任せきりにすると、自組織の業務に合わない検知が残り続けます。
まとめ
検知は、作った瞬間から劣化が始まります。攻撃手口が変わり、システムが変わり、ログの形式が変わるからです。脅威仮説から始め、テストして投入し、品質を測り、改善し続ける。検知を「育てる」仕組みが、アラート過多から抜け出す土台になります。
次回は、生成AIやAIエージェントを、SOCのどこまでの自動化に使えるのか、人間の判断を残すべき境界とあわせて扱います。
主要出典
- MITRE「ATT&CK Detection Strategies」
- MITRE「ATT&CK Updates - October 2025」(v18)
- SigmaHQ「Sigma - Generic Signature Format for SIEM Systems」
- Palantir「Alerting and Detection Strategy Framework」(2017年)
- Red Canary「Atomic Red Team」
本記事は公開情報に基づく一般的な解説です。設計書の記入例は説明用のものであり、検知ロジックは各組織のログ環境に応じて設計してください。