副題:「止まる前提」「離れる前提」で設計する
想定読者:CISO、BCM/BCP担当、クラウドCoE、調達、ITリスク管理
第2回では、ID、設定、データといった自組織の取り組みで防げるリスクを扱いました。最終回の本稿では、その反対側、自組織だけでは防げないリスクを扱います。クラウド事業者の大規模障害、特定の事業者への集中、そして事業者から離れる必要が生じたときの撤退(Exit)です。
1. 事業者の障害は「起きる前提」で考える
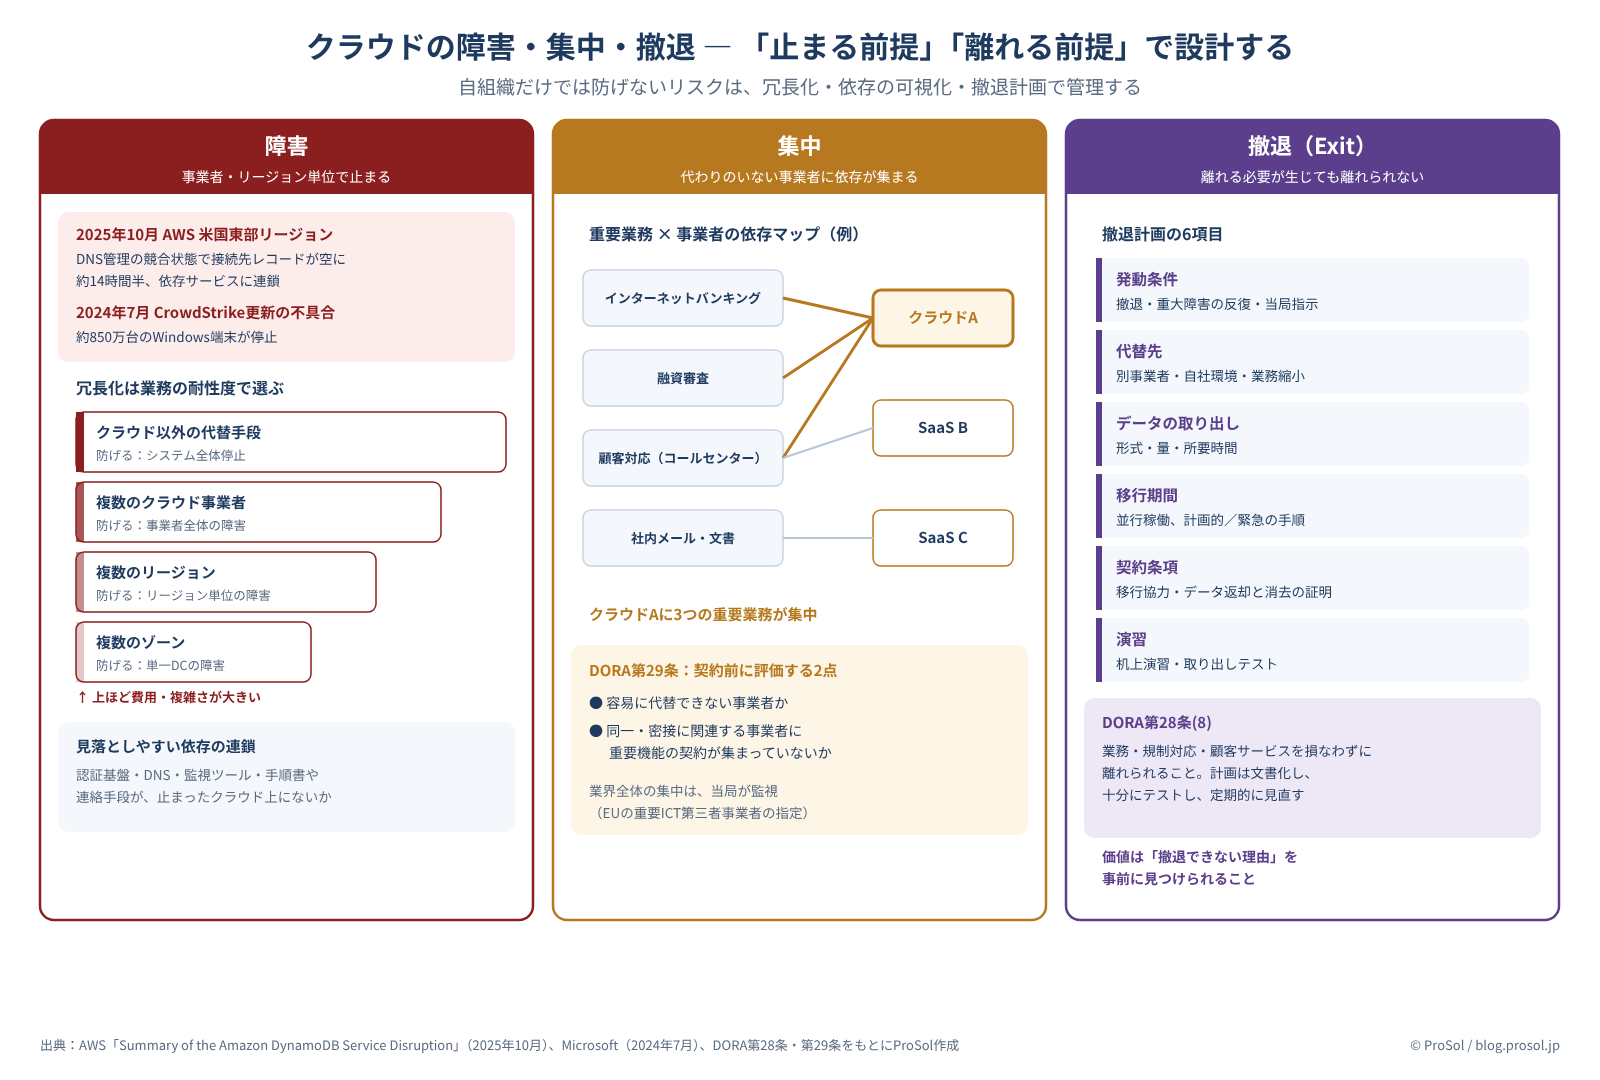
2025年10月19日から20日にかけて、AWSの米国東部(バージニア北部)リージョンで大規模な障害が起きました。AWSの報告によれば、原因はデータベースサービスDynamoDBのDNS管理システムに潜んでいた競合状態で、リージョンの接続先を示すDNSレコードが空になり、自動修復も働きませんでした。影響は約14時間半に及び、DynamoDBに依存する仮想サーバの起動やサーバーレス処理など、他のサービスにも連鎖しました。
2024年7月には、セキュリティ製品CrowdStrikeの更新の不具合で、Microsoftの推計で約850万台のWindows端末が停止しました。Windows全体の1%未満でしたが、1つの事業者の更新が世界中の業務を止めました。
2つの事例が示すのは、どれほど大きな事業者でも止まること、そして自組織が直接使っていなくても、依存先のさらに先で止まりうることです。
2. 自組織だけでは防げない3つのリスク
図1 クラウドの障害・集中・撤退のリスクと備え(© ProSol)
リスク | 起きること | 主な備え |
|---|---|---|
障害 | 事業者やリージョン単位でサービスが止まる | 冗長化、代替手段、障害時にも使える復旧手順 |
集中 | 代替の難しい事業者に、複数の重要業務が依存する | 依存関係の可視化、契約前の集中度評価 |
撤退 | 事業者の撤退、重大な契約違反、当局の指示などで離れる必要が生じる | データの移行性、撤退計画、契約条項、演習 |
3. 障害への備え ― 冗長化は業務の重さで選ぶ
段階 | 防げる障害 | 費用と複雑さ |
|---|---|---|
複数のデータセンター(ゾーン) | 単一のデータセンターの障害 | 小 |
複数のリージョン | 2025年のAWS障害のような、リージョン単位の障害 | 中 |
複数のクラウド事業者 | 事業者全体の障害 | 大(運用と人材の負担も大きい) |
クラウド以外の代替手段 | システム全体の停止(手作業、別チャネルでの継続) | 業務設計による |
すべての業務をマルチクラウドにする必要はありません。Series 04で扱ったとおり、重要業務ごとに定めた耐性度(どこまでの停止なら許容できるか)に照らして、必要な段階を選びます。
見落としやすいのは依存の連鎖です。認証基盤、DNS、監視ツール、そして障害対応の手順書や連絡手段そのものが、止まったクラウドの上にないかを確認します。
4. 集中リスク ― 「代わりがいない」を契約前に見る
EUのDORA(デジタル・オペレーショナル・レジリエンス法)は第29条で、重要な機能を支えるICTサービスを契約する前に、次の2点を評価するよう金融機関に求めています。
- 容易に代替できない事業者と契約することにならないか
- 同じ事業者や密接に関連する事業者に、重要な機能を支える契約が複数集まっていないか
実務では、重要業務と事業者の依存マップを作るのが出発点です。1つの事業者に複数の重要業務が集まっていれば、その事業者が止まったとき同時に止まります。さらに業界全体が同じ事業者に依存していれば、1社の障害が金融システム全体の問題になります。Series 02で扱ったEUの重要ICT第三者事業者の指定は、この業界レベルの集中を当局が監視する仕組みです。
5. Exit Strategy ― 離れられることを証明しておく
DORAは第28条で、重要な機能を支えるICTサービスについて出口戦略(Exit Strategy)を持つよう求めています。要点は次のとおりです。
- 業務の中断、規制への対応、顧客サービスの継続性と品質を損なわずに、契約から離れられること
- 撤退計画は包括的で文書化され、十分にテストされ、定期的に見直されること
- 代替手段を特定し、サービスとデータを事業者から移すための移行計画を作ること
日本でも、金融庁のガイドラインがクラウドの利用終了時にデータの取扱い(論理的な廃棄)を確認することを基本的な対応事項としています。撤退計画には、少なくとも次の項目を盛り込みます。
項目 | 決めておくこと |
|---|---|
発動条件 | 事業者の撤退、重大な障害の繰り返し、重大な契約違反、当局の指示など |
代替先 | 別の事業者、自社環境、業務そのものの縮小や停止 |
データの取り出し | 形式、量、所要時間。取り出したデータが代替先で使えるか |
移行期間 | 並行稼働の期間と、計画的な撤退・緊急時の撤退それぞれの手順 |
契約条項 | 移行への協力義務、終了後の協力期間、データの返却と消去の証明 |
演習 | 机上演習やデータの取り出しテストで、計画が実行できるか確かめる |
撤退計画の最大の価値は、実際に撤退することよりも、撤退できない理由を事前に見つけられることにあります。独自の機能に深く依存していれば、それが集中リスクそのものです。
6. 進め方の3ステップ
- 重要業務ごとに依存先を洗い出す:直接の事業者だけでなく、その先の依存(認証、DNS、監視)まで
- 耐性度と照らしてギャップを特定する:冗長化の段階と、代替手段の有無を確認する
- 契約更改と演習に組み込む:更改時に撤退条項を見直し、年1回は撤退を想定した机上演習を行う
まとめ
クラウドを使うことは、自組織で管理しきれない依存を受け入れることでもあります。だからこそ、止まる前提で冗長化と代替手段を選び、代わりがいない状態を契約前に見つけ、離れられることを計画と演習で確かめておく必要があります。
Series 10では、クラウドで変わる責任、ID・設定・データのリスク、障害・集中・撤退の管理の3つを扱いました。クラウドを禁止するか許可するかの二択ではなく、任せる部分、残る部分、防げない部分をそれぞれ管理することが、金融機関のクラウド活用を支えます。
主要出典
- AWS「Summary of the Amazon DynamoDB Service Disruption in the Northern Virginia (US-EAST-1) Region」(2025年10月)
- Microsoft「Helping our customers through the CrowdStrike outage」(2024年7月)
- Regulation (EU) 2022/2554(DORA)第28条
- Regulation (EU) 2022/2554(DORA)第29条
- 金融庁「金融分野におけるサイバーセキュリティに関するガイドライン」(2024年10月)
本記事は公開情報に基づく一般的な解説であり、法的助言ではありません。DORAの条文は参考訳に基づいて要約しています。正式な条文はEU官報で確認してください。